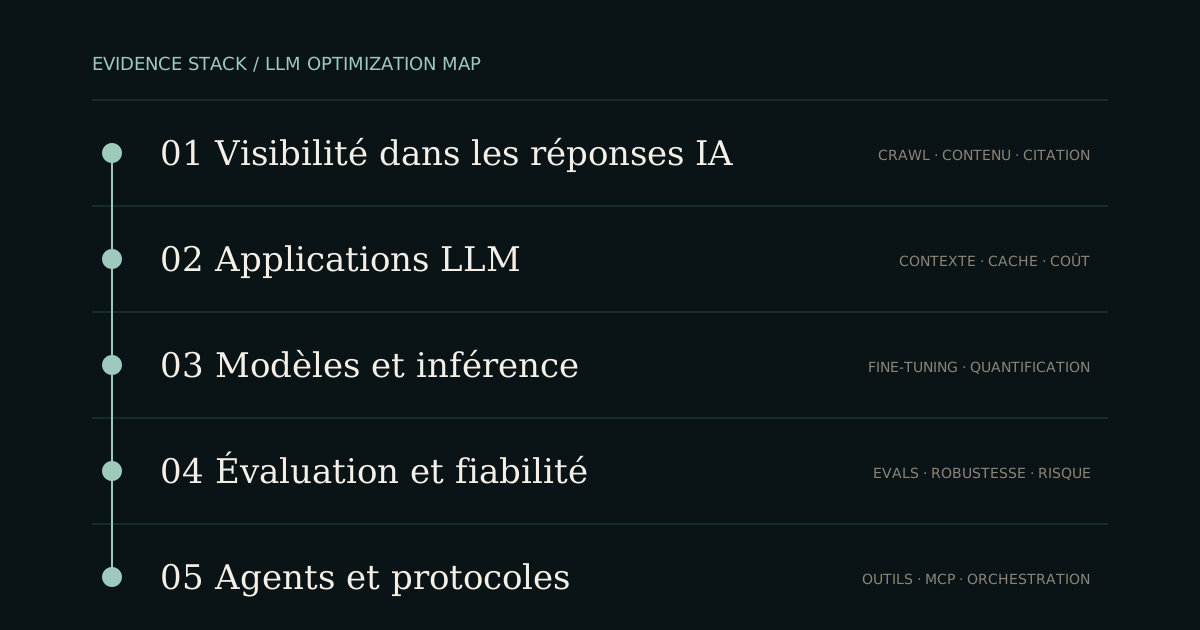
Carte de désambiguïsation

« Optimisation LLM » désigne cinq travaux différents.

Optimiser une page pour qu’elle soit comprise dans une réponse IA, réduire le coût d’une application, compresser un modèle, évaluer sa fiabilité ou connecter un agent à des outils ne mobilise ni les mêmes équipes, ni les mêmes preuves, ni les mêmes métriques.

5 objets distincts6 sources primaires1 calculateur local0 promesse de classement
Carte des cinq disciplines: visibilité IA, applications LLM, modèles, évaluation et agents
La colonne Evidence Stack rappelle qu’une optimisation n’est défendable qu’avec une métrique et une limite adaptées.

Comment choisir la bonne discipline ?

Commencez par compléter cette phrase: « nous optimisons ___ afin d’améliorer ___, mesuré par ___ ». Si le premier blanc désigne une page web, vous êtes probablement dans la visibilité IA. S’il désigne un pipeline ou une API, vous êtes dans l’application. S’il désigne des poids et une inférence, vous êtes dans le modèle.

Cette séparation évite trois erreurs fréquentes: appliquer des conseils de contenu à une contrainte GPU, appeler « GEO » un travail de caching, ou interpréter un score d’évaluation comme une preuve de visibilité organique.

Objet optimiséMétriques défendablesResponsables usuelsPoint de départ
Page ou siteIndexation, impressions, citations observéesSEO, contenu, webMéthode LOOP
Application LLMQualité de tâche, coût, latence, cacheProduit, IA, plateformeJournal de requêtes et evals
ModèleQualité par benchmark, mémoire, débitML engineering, rechercheBaseline reproductible
Système évaluéTaux d’erreur, robustesse, risquesQualité, sécurité, domaineJeu de cas versionné
AgentSuccès de tâche, erreurs d’outil, coûtProduit, engineering, sécuritéContrats d’outil et traces
01
Visibilité dans les réponses IA

Rendre une page accessible, compréhensible et citable

Cette discipline agit sur un site web et sur son contenu. Elle couvre le crawl, l’indexation, la structure, l’autorité thématique, les passages autoportants, les entités et la mesure des mentions ou citations observables. C’est le cœur historique de llmoptimisation.fr.

Dans son guide consacré aux fonctions génératives de Search, Google renvoie aux fondamentaux SEO: accès au crawl, indexabilité, contenu textuel disponible, liens internes, expérience de page, images et vidéos de qualité, données structurées cohérentes avec le visible. Google précise également qu’aucun fichier spécial ni balisage Schema.org dédié n’est nécessaire pour apparaître dans ces fonctions.

Appliquer le parcours d’optimisation d’un site, puis utiliser l’observatoire pour séparer mesure et intuition.

02
Applications LLM

Optimiser le contexte, le routage, la latence et le coût

Une application LLM s’optimise comme un système logiciel mesuré de bout en bout. Le choix du modèle, la construction du contexte, la récupération documentaire, les appels d’outils, le caching, les limites de débit et l’observabilité doivent être reliés à des évaluations de qualité.

OpenAI documente le prompt caching pour les préfixes répétitifs et expose les tokens mis en cache dans les données d’usage. Google documente également un mécanisme de context caching dans Gemini. Ces fonctions sont propres aux plateformes et évoluent: leur disponibilité, leur facturation et leurs seuils doivent être relus avant toute décision d’architecture.

03
Modèles et inférence

Fine-tuning, quantification, distillation et benchmarks

Ici, l’objet optimisé est le modèle ou son exécution. La quantification représente les poids, et parfois les activations, avec une précision réduite afin de diminuer l’empreinte mémoire et potentiellement accélérer l’inférence. Le compromis doit être évalué sur le matériel et les tâches cibles.

La documentation Transformers de Hugging Face distingue plusieurs méthodes, matériels supportés, niveaux de précision et besoins éventuels de calibration. Elle rappelle qu’il n’existe pas une méthode universellement meilleure: le choix dépend du cas d’usage et de l’environnement.

Estimation minimale de mémoire des poids

3,73 GiB environ pour 8 milliards de paramètres à 4 bits, poids seuls.

Formule affichée: paramètres × bits ÷ 8, convertis en GiB. Cette estimation ne remplace pas un benchmark.

04
Évaluation et fiabilité

Mesurer avant de déclarer une amélioration

Une optimisation n’existe que relativement à un critère. Les evals formalisent des entrées, sorties attendues, graders, versions et résultats afin de comparer un changement de prompt, de modèle, de contexte ou d’outil. Elles doivent inclure les cas importants, les échecs et les régressions.

OpenAI recommande un processus d’évaluation reproductible pour tester les sorties. Le NIST AI RMF et son profil consacré à l’IA générative fournissent un cadre volontaire pour gouverner, cartographier, mesurer et gérer les risques. Aucun de ces documents ne transforme un score interne en preuve générale de sûreté.

05
Agents et protocoles

Connecter des modèles à des outils sans confondre accès et fiabilité

Un agent orchestre un modèle, un état et des actions. Son optimisation porte sur la sélection d’outils, les contrats d’entrée et de sortie, les permissions, la mémoire, les reprises sur erreur, le coût et la réussite de tâches complètes. Le modèle n’est qu’un composant du système.

La documentation officielle décrit MCP comme un standard open source permettant de connecter des applications IA à des sources de données, des outils et des workflows. Cette interopérabilité n’évalue pas la qualité d’un serveur, la sécurité de ses actions ou la pertinence d’un résultat: ces contrôles restent à la charge du système qui l’utilise.

Pour ce domaine, le prochain travail à forte valeur n’est pas une série de définitions génériques. Ce sont des protocoles originaux: taux d’échec d’outils, contrats de sortie, coût par tâche réussie et publication des cas négatifs.

Questions de désambiguïsation

Les réponses courtes à conserver

LLMO signifie-t-il toujours optimiser un site pour ChatGPT ?

Non. Selon le contexte, « LLM optimization » peut viser la visibilité d’un contenu dans les réponses IA, les performances d’une application utilisant un modèle, ou le modèle lui-même. La première étape consiste donc à nommer l’objet optimisé et la métrique suivie.

Le SEO pour les fonctions IA de Google demande-t-il un balisage spécial ?

Google indique que les fondamentaux SEO restent valables pour ses fonctions IA et qu’aucun fichier spécial ni balisage Schema.org particulier n’est requis pour y apparaître. Les données structurées doivent correspondre au contenu visible et respecter leurs règles propres.

La quantification et le prompt caching résolvent-ils le même problème ?

Non. La quantification réduit la précision utilisée pour représenter les poids ou activations d’un modèle afin de réduire notamment la mémoire. Le prompt caching réutilise des préfixes de contexte déjà traités pour réduire le coût ou la latence de requêtes répétitives.

Pourquoi séparer les évaluations des optimisations de coût ?

Une baisse de coût ou de latence ne démontre pas que la qualité reste acceptable. Les évaluations doivent tester les comportements importants avec des jeux de cas, des critères et un historique distincts des métriques d’infrastructure.

MCP est-il un moteur de recherche ou un système de classement ?

Non. Le Model Context Protocol est un standard ouvert pour connecter des applications IA à des données, outils et workflows. Il relève de l’intégration et de l’orchestration, pas du classement des pages dans Google ou dans un moteur de réponse.